
虽然基于云的 ChatGPT 和 Bard 正在受到关注,可以在自己的电脑上完成的“本地LLM(大规模语言模型)”正在悄悄地掀起一场革命。尤其是支持日语的本土法学硕士,从保护企业机密信息、确保隐私的角度,在商界迅速受到关注。
在本文中,我们将解释如何在普通 PC 上操作它。本地法学硕士,有日语支持我们将彻底检查软件的最新趋势和实际性能以及具体的输出示例。现在即使离线也可以生成高质量的日语,我们将解释其实用性以及如何介绍它。
本文内容在上面的GPT主播室以简单易懂的音频进行讲解。
什么是本地LLM? —不依赖云的下一代AI平台
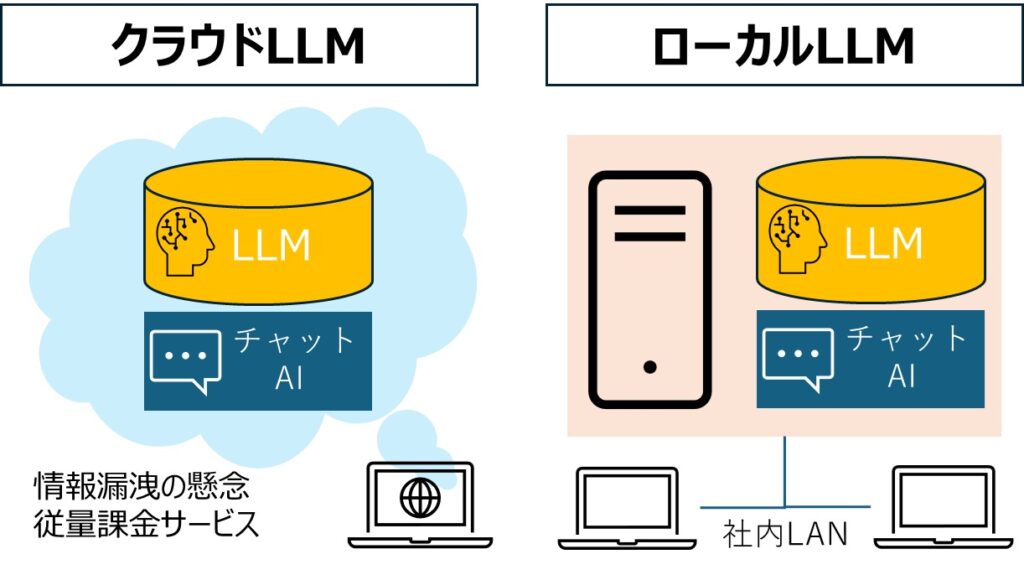
本地LLM是一种大规模语言模型,可以在不需要互联网连接的本地环境(例如个人PC或企业服务器)中完成。最大的三个特点是:
- 离线工作,无需互联网连接
- 数据在本地处理,提供出色的隐私保护
- 无持续使用费(仅初始安装费用)
传统上,LLM需要高性能GPU和大容量内存,并且一般在云端运行。然而,随着技术的进步,轻量化和量化的进步,现在可以在通用PC上运行开源LLM模型。这一变化为企业和个人用户创造了新的选择。
特色日本兼容本地法学硕士——不断发展的国内人工智能技术
本土日语处理专业的法学硕士纷纷出现,并已达到实用水平。下面介绍代表性型号。
① LLAMA-3-ELYZA-JP-8B-AWQ:日语专用轻量级模型
这是国内人工智能公司ELYZA基于Meta开发的Llama-3开发的专门针对日语的高性能模型。其最大特点是采用“量化技术”的轻量化设计,即使在普通笔记本电脑上也能流畅运行。
什么是量子化技术?
一种使用低精度位宽表达LLM模型参数和激活的技术,显着减少内存使用和计算负载。可以减少所需的资源,同时保持大部分准确性。
② Mistral-Nemo-日语-Instruct:实用日语模型
CyberAgent发布的日本兼容型号,LM工作室推荐使用上面的方法。具有日本高性能的实用模型它被评为。
什么是LM工作室?
它是一个开源软件,允许您在本地环境中运行 LLM。它支持离线自然语言处理,并与 Mac、Windows 和 Linux 兼容。
③ Gemma2 Baku 2B:日本加工能力强
Gemma 2 Baku 2B 基于 Google 发布的大规模语言模型(LLM)Gemma 2 2B,由 Rinna Co., Ltd. 开发。日语能力增强的模特是。该模型使用 800 亿个 token 的日语和英语学习数据持续进行预训练,提高其日语处理能力。
这些模型的参数数量相对较少,为 26 亿个,因此虽然轻量级,但它具有很高的文本生成能力,并且在推理时具有很高的性价比。它被评为
本地LLM部署指南——打造你自己的AI助手
适当的硬件配置和软件设置对于在本地环境中运行 LLM 至关重要。下面,我们就具体的实施步骤进行讲解。
3-1.所需硬件配置
为了最大化LLM的表现,GPU性能尤为重要是。请参阅下面的推荐规格。
最新的轻量级型号或许能够在没有 GPU 的笔记本电脑上运行,但在响应速度和处理能力方面存在限制。
2、软件设置
硬件准备就绪后,请按照以下步骤配置软件。
- 安装Python:从官网下载Python并安装。
- 安装所需的库:
pip使用以下命令安装以下库:- bash代码
pip install transformers torch
- bash代码
- 下载模型:从 Hugging Face 等平台下载您要使用的模型。支持日语的型号包括 Llama-3-ELYZA-JP-8B-AWQ 和 Mistral-Nemo- Japanese-Instruct。
- 加载并运行模型:使用下面的Python代码加载模型并进行文本生成。
- 蟒蛇代码
from transformers import AutoTokenizer, AutoModelForCausalLM tokenizer = AutoTokenizer.from_pretrained("モデル名") model = AutoModelForCausalLM.from_pretrained("モデル名") input_text = "こんにちは、今日はどのようにお手伝いできますか?" inputs = tokenizer(input_text, return_tensors="pt") outputs = model.generate(**inputs) print(tokenizer.decode(outputs[0], skip_special_tokens=True))
- 蟒蛇代码
通过执行这些步骤,您将能够在本地环境中使用 LLM 生成日语文本。
为企业提供本地法学硕士建设服务
出于安全考虑,一些公司正在限制 ChatGPT 等生成式人工智能的使用。
另外,企业业务数据有复用的需求,因此为企业提供本地法学硕士建设服务正在引起人们的注意。如果您有兴趣,请往下看。
实证验证:本土LLM的日语生成能力
为了不仅确认理论性能,而且确认实际可用性,我们使用具有以下通用规格的 Windows PC 测试了每个型号的日文生成能力。
- 操作系统:Windows 11
- CPU:英特尔酷睿i7
- 内存:16GB
- GPU:无(仅限集成显卡)
值得注意的是,以下验证是在没有GPU的环境下进行的。
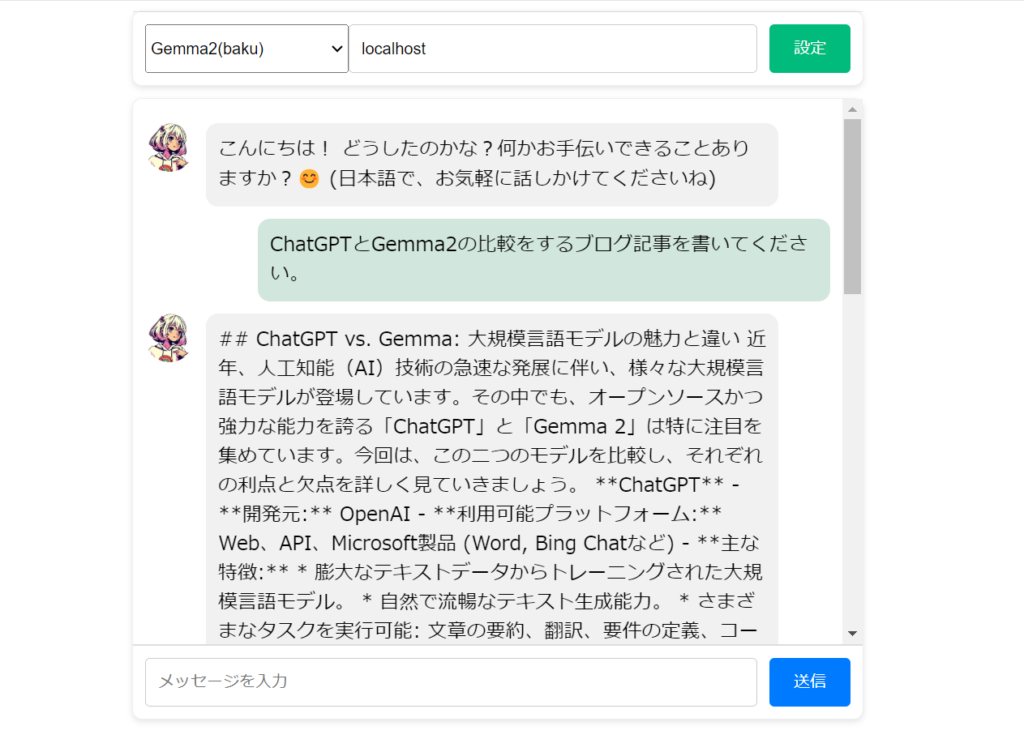
日本一代的成果①
下图是使用 Gemma2 Baku 2B 模型的输出示例。
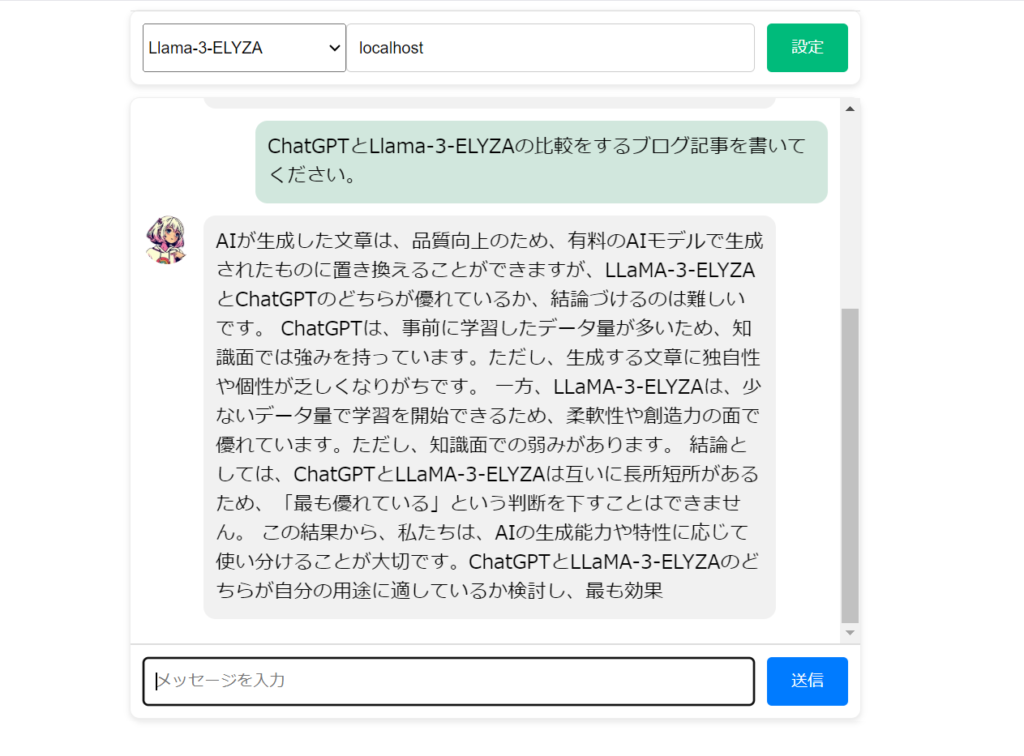
日本一代的成果②
以下是使用模型 Llama-3-ELYZA-JP-8B-AWQ 的示例输出。
日本生成结果③
以下是使用 Llama-3.2 Vision 模型的示例输出。

RAG(检索增强生成)和微调是与自然语言处理主题相关的两个重要概念。 ### RAG(检索增强生成) RAG 是一种模型从给定输入的现有文档和数据中搜索相关信息,并将其合并到生成的句子中的技术。该模型不是根据原始输入创建新句子,而是搜索相关信息并使用它来创建句子。 RAG 模型执行以下过程: 1.文件检索:模型根据输入搜索相关文档和数据。 2.信息提取:模型从搜索结果中提取相关信息。 3.生成:模型将提取的信息合并到原始输入中以创建新句子。 RAG 模型有助于提供对特定任务或主题的深入理解和知识。例如,在问答系统中,RAG 模型可以从现有文档中检索相关信息并使用它来创建正确答案。 ### 微调 微调是使用有关特定任务或主题的数据重新训练现有模型的过程。原始模型经过预训练,对于特定任务表现良好,但微调涉及重新训练它以将知识和能力应用于特定任务。微调过程包括以下步骤: 1.获取现有模型:确保原始模型经过预训练并且可用。 2.数据准备:准备有关特定任务或主题的数据并将其提供给原始模型。 3.再培训:再次训练原始模型,使其在特定任务中表现良好。微调通过向现有模型添加新知识或能力来帮助提高现有模型的性能。例如,在问答系统中,可以使用问答数据重新训练原始模型以产生更准确的答案。主要区别* RAG模型是一种从现有文档中搜索相关信息并将其合并到生成句子中的技术。 * 微调是使用特定任务或主题的数据重新训练现有模型的过程。这两种方法都有助于提高自然语言处理性能,但它们的目标和方法不同。
日本一代的成果④
下图是使用 Gemma2 Baku 2B 模型的新闻文章摘要的输出示例。
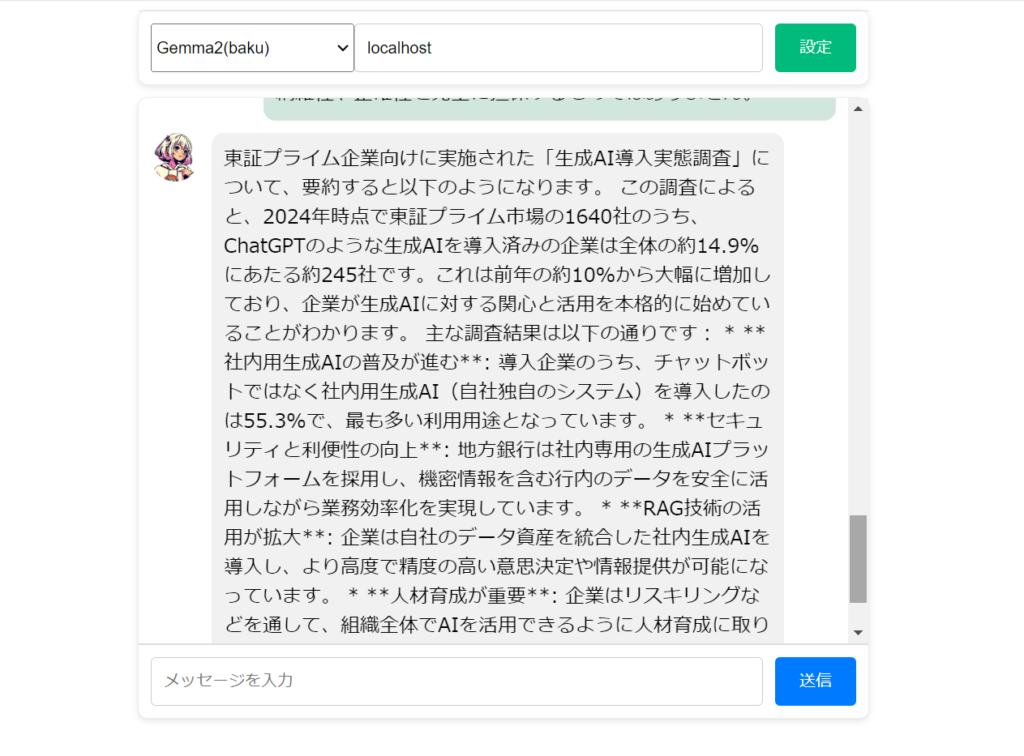
以下是针对东京证券交易所主要公司进行的“生成式人工智能实施调查”的摘要。根据这项调查,截至 2024 年,在 TSE Prime Market 的 1,640 家公司中,约有 245 家公司(约占总数的 14.9%)引入了 ChatGPT 等生成式人工智能。这比上一年约 10% 显着增长,表明企业开始充分利用和利用生成式人工智能。主要调查结果如下: * **内部生成的人工智能变得越来越流行**:55.3%的公司引入了内部生成的人工智能(他们自己的系统)而不是聊天机器人,使其成为最常见的用例。 * **提高安全性和便利性**:一家区域银行采用了内部生成式人工智能平台,以提高运营效率,同时安全地利用包括机密信息在内的内部数据。 * **越来越多地使用 RAG 技术**:公司正在实施内部生成的人工智能,集成自己的数据资产,从而实现更先进、更准确的决策和信息提供。 * **人力资源开发很重要**:公司正在努力通过再培训和其他方式开发人力资源,使他们能够在整个组织中利用人工智能。本次调查结果表明,企业积极使用生成式人工智能正在加速,这可能对未来获得竞争优势和提高运营效率产生重大影响。
原文:关于 TSE Prime 公司开展的人工智能实施调查
参考(ChatGPT4o总结同一篇文章的结果)
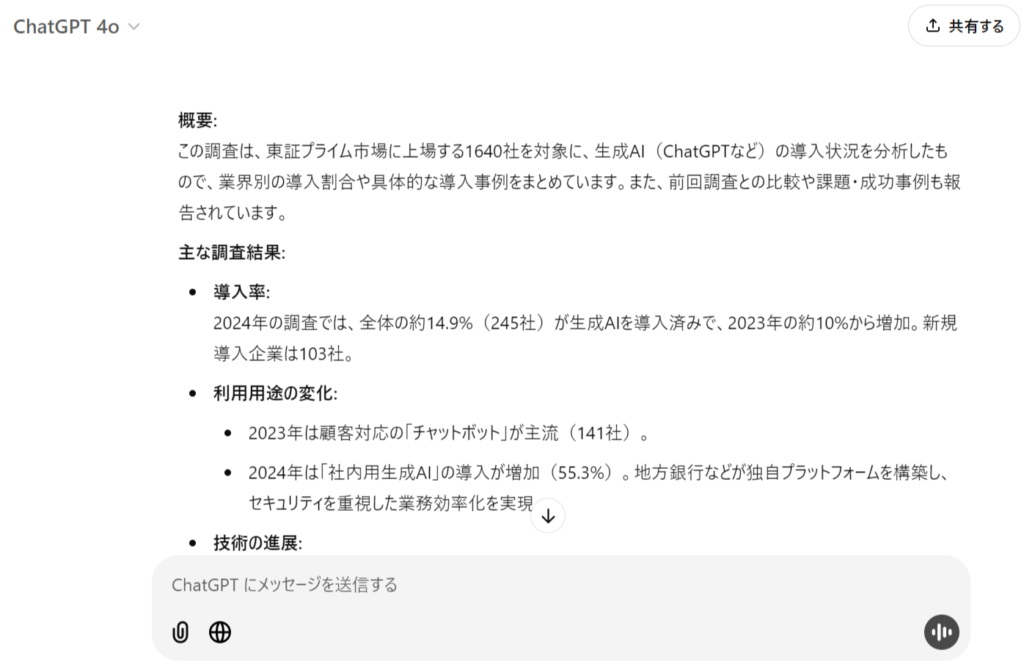
使用本地 LLM 生成日语的能力因型号和硬件环境而异。例如,当使用 Llama-3-ELYZA-JP-8B-AWQ 时,20~30秒程度据报道可以生成高质量的日语文本。
另一方面,Mistral-Nemo- Japanese-Instruct在日语方面表现出色,被评价为实用模型。但是,您需要安装 LM Studio 才能使用它。
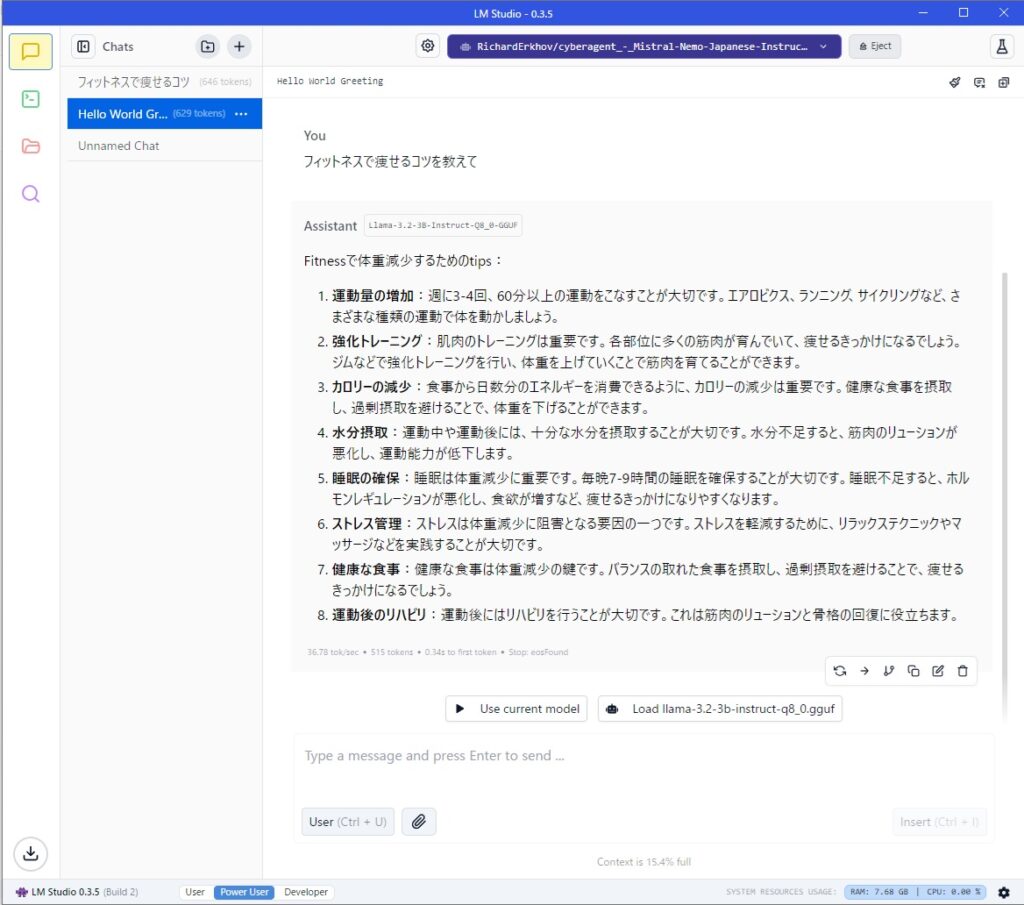
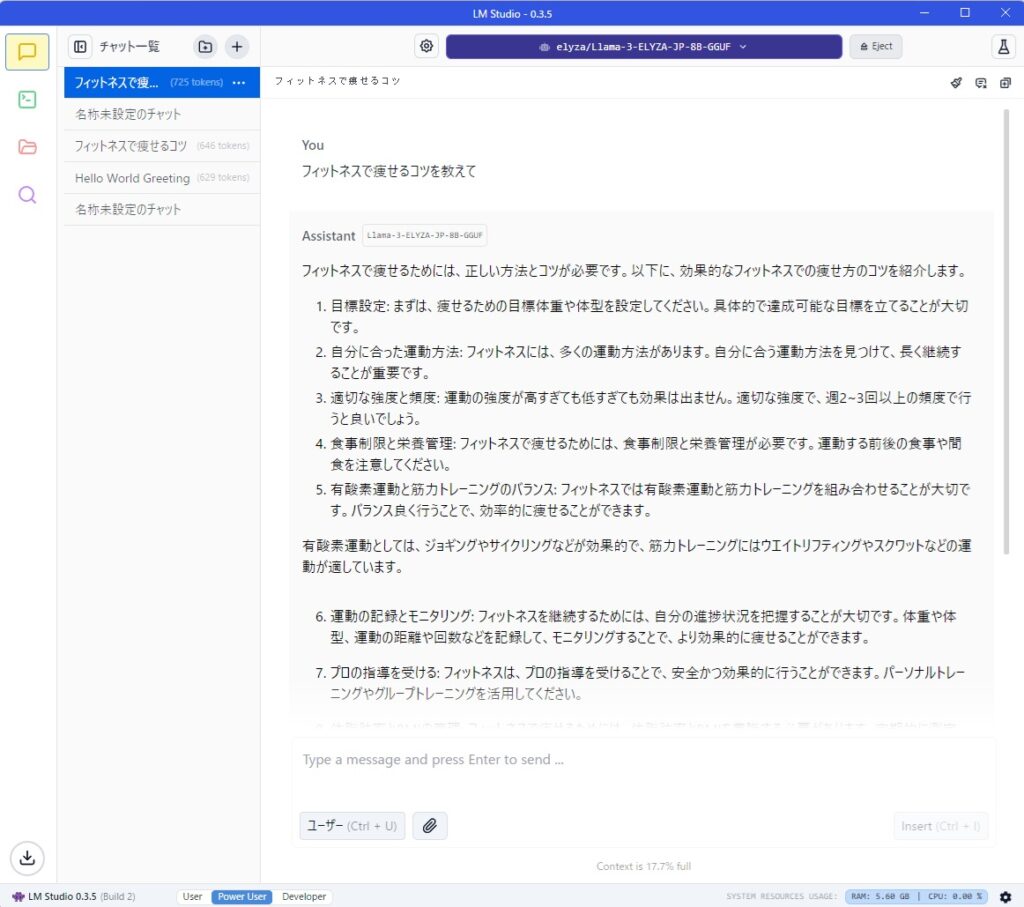
使用 LM Studio 的本地 LLM 日语输出示例
日本一代结果⑤
Cyberagent/Mistral-Nemo- Japanese-Instruct 的日语输出
日本一代结果⑥
日本产Llama-3-ELYZA-JP
使用本地法学硕士的日本一代:总结

由于技术的进步,使用本地LLM的日语生成已经可以在普通PC上实现,并且从安全和隐私的角度受到关注。
最近,据说可以在智能手机上运行的本地LLM模型也出现了。如果您有兴趣,请往下看。